Инструкция по оцифровке книги из библиотеки
29.09.2026
За основу взят источник из Library Bson.
Введение
Книга — это опыт, зафиксированный на бумаге (опредмеченный опыт). Поскольку один физический экземпляр не могут читать все сразу, книги нужно оцифровывать и распространять. Эта инструкция поможет новым оцифровщикам разобраться начать работу.
Этап поиска книги
Пункт для читателя
Сначала проверьте текстологические сообщества и библиотеки:
- Коллектив Comtext
- Коллектив Сократ
- Коллектив Library Bson
Эти сообщества занимаются поиском книг и их оцифровкой. Если книга имеется у них, то можно запросить в доступном формате. Если нет, то можно предложить им ее найти.
Пункт для оцифровщика
Ищите книгу в крупных хранилищах PDF и электронных библиотеках:
Основная задача этого этапа — найти скан книги и избежать этап библиотеки.
Этап библиотеки
Цель этапа — сделать скан физической книги.
Подготовка
Проверьте каталог: убедитесь, что книга есть в фонде. Заранее оформите читательский билет.
В самой библиотеке
Закажите и получите книгу. Убедитесь, что она не из отдела редких книг и библиотека разрешает фотосъемку.
Снимайте аккуратно, не спеша и берегите книгу. Процесс требует времени и усидчивости, поэтому планируйте поход в библиотеку с запасом.
Сначала отснимите обложку и титульные страницы с выходными данными: названием, автором, издательством, годом и номером издания. Эти данные понадобятся для метаданных.
Приемы съемки:
По четным и нечетным. Сначала сфотографируйте все четные страницы, затем — нечетные. Это ускорит работу, но потом фотографии придется рассортировать.
Разворотом целиком. Снимайте две страницы сразу. Для этого книга должна хорошо раскрываться. Учтите: нейросетям потом будет сложнее распознавать текст на таких фото.
Перед тем как сдать книгу, проверьте качество снимков и удалите дубликаты.
Примеры
Ниже — проверенные инструкции для конкретных библиотек.
РГБ (Москва)
Чтобы заказать книгу в РГБ, зайдите на сайт rsl.ru. В поисковую строку справа вверху введите название, автора, год издания или другие параметры.
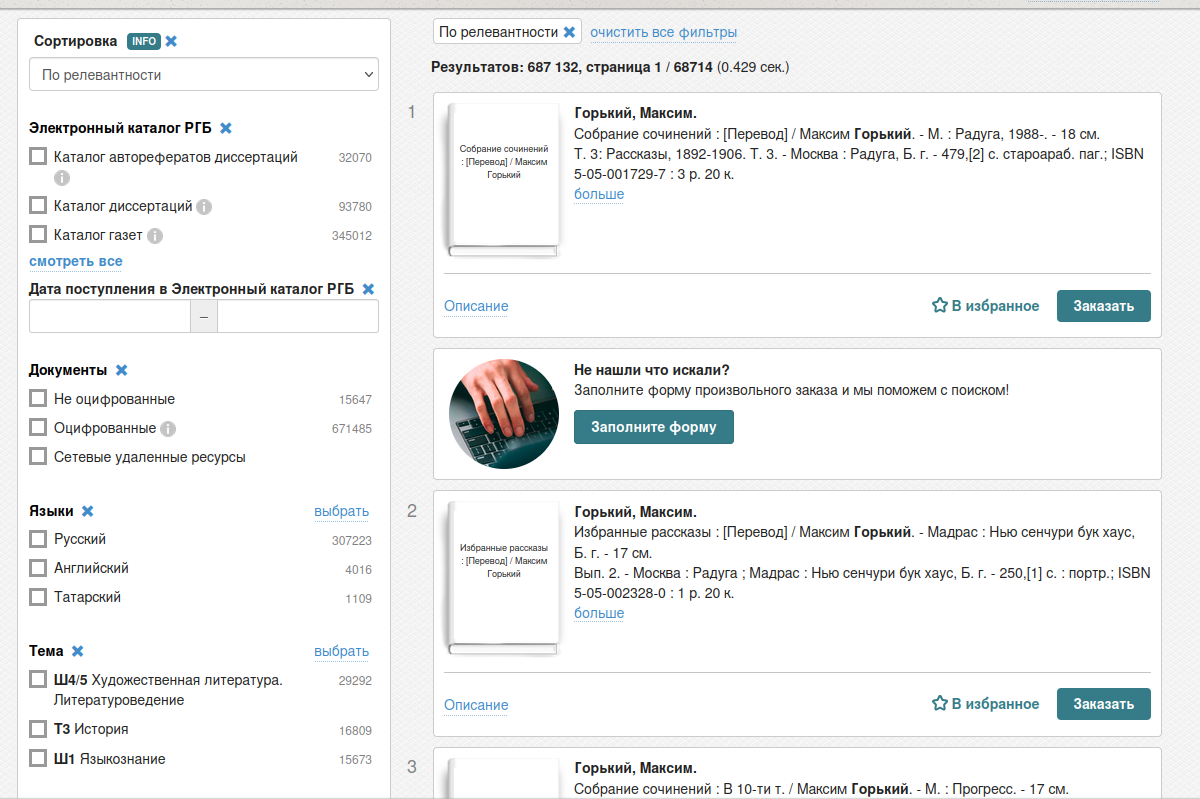
На странице выдачи слева можно уточнить параметры и отсортировать результаты.
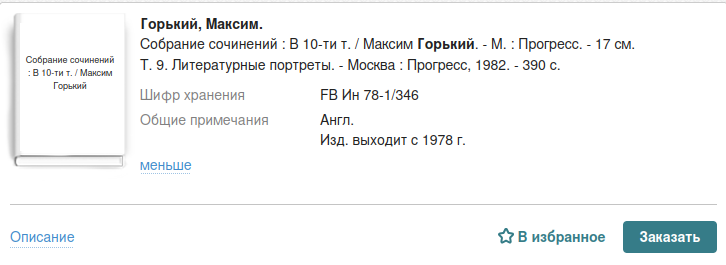
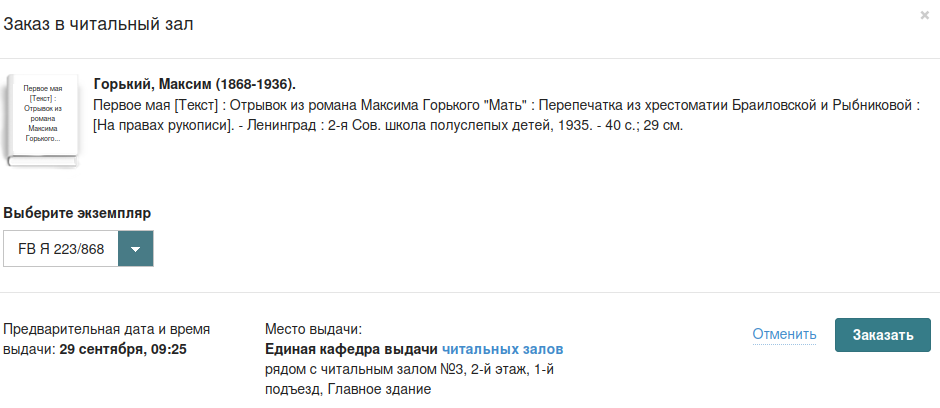
В карточке книги ищите шифр — он подсказывает, где искать издание. Например, буквы FB означают основной фонд в главном здании в Москве.
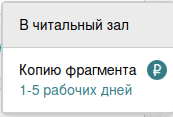
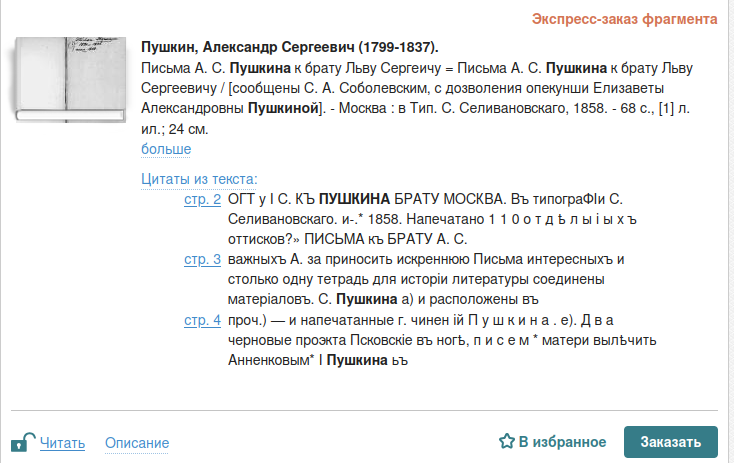
Книгу можно забрать в читальном зале или заказать скан фрагмента за плату (это займет время).
Если в каталоге несколько изданий, система предложит выбрать нужную версию и место выдачи. Внимательно смотрите на шифр, чтобы не ошибиться с корпусом.
В РГБ есть фонд оцифрованных книг. Если авторское право истекло, скан можно скачать или прочитать онлайн (ссылка обычно слева внизу). Если книга под защитой, ее можно читать только на компьютерах библиотеки или в читальном зале. Такие книги распространять нельзя.
Этап Оцифровки
Перед началом работы выберите формат: Markdown, HTML, Comtext и т. д.
Объединение сканов в pdf
Подготовка сканов:
- Создайте на компьютере отдельную папку.
- Скопируйте в нее все фотографии.
- Переименуйте файлы так, чтобы их было удобно сортировать.
Объединить фото в PDF можно на онлайн-сервисах, но надежнее использовать локальные программы:
- В Linux подойдет команда
convert(объединяет изображения в один файл) илиpdfunite(если нужно склеить несколько PDF). - Подсказки по синтаксису команд можно запросить в ChatGPT или DeepSeek.
- При необходимости аналогичный скрипт можно написать на Python или другом языке.
Перепечатывание
Раньше перепечатка отнимала больше всего времени, теперь, благодаря нейросетям, это занимает менее 1% усилий.
Сервисы для распознавания текста (OCR):
- https://www.datalab.to/
- https://aistudio.baidu.com/paddleocr/task/new
- На системах Apple есть встроенная система распознавания.
Они быстро и точно конвертируют сканы в Markdown.
Тем не менее, навык ручной перепечатки важен: доступ к нейросетям бывает ограничен. Удобный инструмент для перепечатки и вычитки — Obsidian. Откройте PDF справа, а Markdown-файл ведите слева.
Также остро стоит потребность в собственной локальной некоммерческой нейросети для OCR. Создание такого инструмента может стать отличным проектом для текстологических коллективов.
Вычитка
Готовый Markdown нужно вычитать: исправить ошибки распознавания и форматирования. Проверьте корректность ссылок и иерархию заголовков. На этом же этапе заполните метаданные книги.
После вычитки текст считается оцифрованной книгой.